 MetaStocker
CSV и экспорт
Как найти дубли строк в CSV со стоковыми данными
Дублирующуюся строку в CSV легко не заметить в большой партии файлов, но при импорте она может создать противоречивые метаданные для одного изображения. Надёжная проверка состоит не только в поиске полностью одинаковых строк: сначала сравните имя файла после проверки его написания, затем сопоставьте заголовок, ключевые слова, категорию и данные о релизе. Ниже приведён практический сценарий с одним файлом. Пример гипотетический: это не измеренный результат и не история реального клиента.
В рабочем файле две строки относятся к одному объекту — «coffee-pour.jpg». Первая описывает крупный план: кофе наливают в керамическую чашку. Вторая ошибочно представляет тот же файл как фотографию упаковки кофе. Задача — обнаружить конфликт, выбрать строку, подтверждённую доступными сведениями, и экспортировать только чистый набор записей.
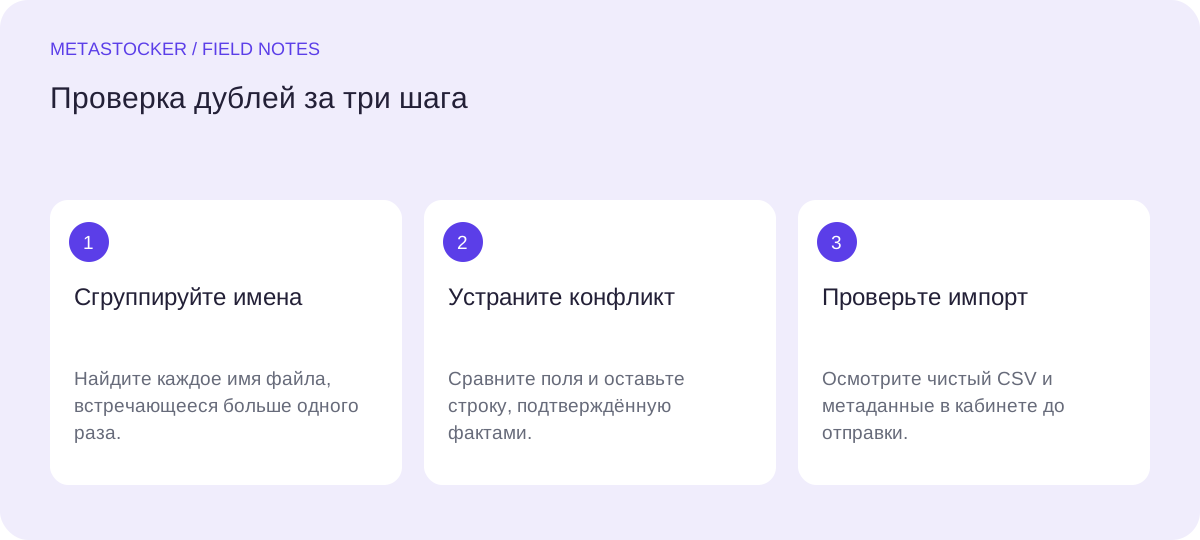
1. Начните с изображения, а не с CSV
Перед проверкой дубля убедитесь, к какому объекту относится имя файла. Имя файла — это идентификатор, а не доказательство того, что изображено на снимке. Откройте файл и проверьте видимые предметы, действие и композицию. Не определяйте по пикселям личность человека, владельца, место, состав или материал, если это не подтверждено.
Для нашего примера фотограф передал такие заметки со съёмки: «Студийный натюрморт; кофе наливают в керамическую чашку; за чашкой стоит крафтовый пакет кофе; бренд не указан». Это доступные невербальные сведения. Они помогают сформулировать описание, но не дают оснований придумывать происхождение кофе, владельца, рецепт или коммерческий бренд.
- Сохраняйте исходное расширение и регистр имени файла.
- Отделяйте заметки со съёмки от выводов, сделанных только по изображению.
- Сомнительную деталь лучше убрать, чем превращать её в ключевое слово.
2. Ищите дубли по нормализованному имени
Сначала проверьте имена файлов. Сопоставляйте полное имя вместе с расширением и регистром: платформа может требовать точного совпадения. Для внутренней проверки можно создать дополнительное нормализованное значение — убрать случайные пробелы и привести буквы к одному регистру. В самом экспорте исходное имя менять нельзя.
В нашем примере coffee-pour.jpg встречается дважды, поэтому строки попадают в одну группу дублей. Имя coffee-pour.JPG может быть отдельной проблемой, если платформа различает регистр. Не объединяйте такие строки автоматически, пока не проверите актуальные требования кабинета автора.
- Сначала группируйте строки по точному имени файла.
- Помечайте группы, где строк больше одной.
- Затем сравнивайте все поля внутри каждой группы.
Группа дублей
filename: coffee-pour.jpg
строка 14: coffee poured into ceramic cup; ключевые слова: coffee, pouring, cup
строка 37: packaged coffee bag product; ключевые слова: bag, packaging, brand
3. Сравнивайте поля, а не только строки
Две строки могут отличаться лишь порядком ключевых слов и при этом описывать один и тот же корректный вариант. Но небольшая разница в формулировке иногда показывает серьёзный фактический конфликт. Сравните заголовок, список ключевых слов, категорию, имя релиза и другие поля, которые нужны конкретной площадке.
В нашем примере первая строка подтверждается изображением и заметками со съёмки. Вторая превращает снимок в фотографию товарной упаковки и содержит слово «brand», хотя в заметках сказано, что бренд не указан. Крафтовый пакет действительно виден, поэтому выражение coffee bag может быть уместным, если пакет заметен и релевантен, но строка не должна выдавать неопознанный объект за брендированный товар.
- Отделяйте безобидный разный порядок слов от фактического конфликта.
- Ищите неподтверждённые утверждения о личности, владельце, месте или бренде.
- Проверьте, относится ли файл релиза именно к этому изображению.
4. Выберите строку по доказательствам
Не решайте спор в пользу более длинного заголовка или строки с большим числом ключевых слов. Оставьте вариант, который точно описывает объект и соответствует текущим правилам выбранного стока. Релевантные термины должны относиться к работе; повторяющиеся и лишние слова ухудшают запись.
Для гипотетического примера оставьте одну исправленную строку с заголовком “Coffee poured into ceramic cup with coffee bag in background”. Подходящие слова могут включать coffee, pouring, ceramic cup, beverage и still life, если они действительно описывают изображение. Уберите brand: заметки не подтверждают наличие бренда. Если пакет занимает небольшую часть кадра, лучше не делать coffee bag равным по важности основному действию.
- Выбирайте одну защищаемую фактами строку вместо нескольких догадок.
- Если правила площадки этого требуют, ставьте главные термины в начало.
- Проверяйте актуальные ограничения площадки по заголовку и ключевым словам.
5. Проверьте чистый экспорт до импорта
После обработки всех групп дублей повторите проверку уже готового экспорта. В финальном файле для coffee-pour.jpg должна остаться одна строка, а имя должно в точности совпадать с загруженным файлом. В актуальном руководстве Adobe CSV указаны обязательные заголовки и поля filename, title и keywords; категория и имя файла релиза могут быть дополнительными полями. Перед загрузкой всё равно проверьте текущие ограничения и правила.
Если вы используете MetaStocker для генерации или редактирования метаданных, просмотрите результаты по каждому файлу и экспортируйте только готовые строки. Экспортёр создаёт CSV, но не загружает и не отправляет его на площадку, а также не встраивает метаданные в оригиналы. Поэтому проверка дублей остаётся отдельным шагом перед импортом.
- После очистки пересчитайте имена файлов.
- Проверьте обязательные заголовки и текущие ограничения площадки.
- Откройте CSV как обычный текст или в таблице и осмотрите итоговую строку.
6. Импортируйте осторожно и проверьте кабинет
Если площадка требует определённого порядка, сначала загрузите соответствующие изображения, а затем импортируйте CSV. Совпадение имени и регистра важно. После импорта проверьте получившиеся метаданные в кабинете автора, а не исходите из того, что формально корректный CSV применился без ошибок.
Правила площадок и экраны загрузки меняются, поэтому непосредственно перед отправкой откройте актуальный кабинет автора. Отсутствие дублей устраняет одну распространённую причину путаницы, но не гарантирует принятие файла, показы, продажи или высокую позицию в поиске. Индексация сайта Google — отдельная тема; внутренний поиск стока и SEO веб-сайта нельзя смешивать. Этот процесс относится только к метаданным стоковой площадки.
- Сохраните проверенную копию CSV.
- После большой загрузки сверяйте импортированную строку с самим файлом.
- Если конфликт остался, остановите импорт и исправьте CSV.
Перед следующим шагом
- Откройте изображение и прочитайте доступные заметки со съёмки.
- Сгруппируйте строки по полному имени файла, включая расширение и регистр.
- Отметьте каждое имя, которое встречается более одного раза.
- Сравните заголовки, ключевые слова, категории и поля релиза.
- Удалите неподтверждённые заявления, например о бренде.
- Оставьте по одной подтверждённой строке на каждый файл.
- Проверьте актуальные требования площадки к CSV.
- При необходимости сначала загрузите файлы, затем проверьте метаданные в кабинете.
Источники и редакционный подход
Материал подготовлен с помощью AI. Примеры в тексте учебные. Автоматические проверки не заменяют проверки требований вашего стока. Как мы готовим материалы.