 MetaStocker
Локальный AI
Как спланировать локальную разметку 120 файлов
Планировать метаданные для 120 файлов проще, если отдельно считать подготовку модели, генерацию, проверку, экспорт и возможный API-счёт. Локальная обработка может не требовать оплаты API, но всё равно занимает время компьютера, место на диске и внимание автора. Дополнительный режим OpenAI требует ещё и проверки фактического расхода в аккаунте провайдера.
Числа ниже — только условный пример рабочего листа, а не измерение продукта и не обещание скорости. Сначала измерьте свой небольшой фрагмент на своём браузере, компьютере и наборе файлов, затем перенесите наблюдения на всю партию.
Сначала опишите партию
Запишите, что объединяет 120 файлов: типы файлов, коммерческое или редакционное назначение, однородность сюжетов и наличие видео. Смешанная папка обычно требует больше ручных исправлений, чем серия похожих изображений.
Заранее укажите площадку и язык метаданных. Для Adobe Stock общая справка допускает до 49 ключевых слов, но перед CSV-загрузкой всё равно нужно проверить актуальные правила и экран портала. Русский язык этой статьи не означает, что метаданные можно писать по-русски: если площадка требует английский, пример должен быть английским.
Не превращайте неизвестное в факт. По пикселям нельзя уверенно устанавливать личность человека, точное место, наличие релиза или вид животного. Такие пункты нужно оставить на проверку или не включать.
- Количество: 120 файлов
- Выбранная локальная модель и число тегов
- Ожидаемое время проверки одного файла
- Целевая площадка и её текущие ограничения
- Файлы, требующие особого внимания
Строка планирования:
Партия: 120 изображений
Цель: английские метаданные для Adobe Stock
Плановый предел: 49 ключевых слов, с проверкой актуальных правил
Не подтверждено: личность, место, релизы
Измерьте локальный образец
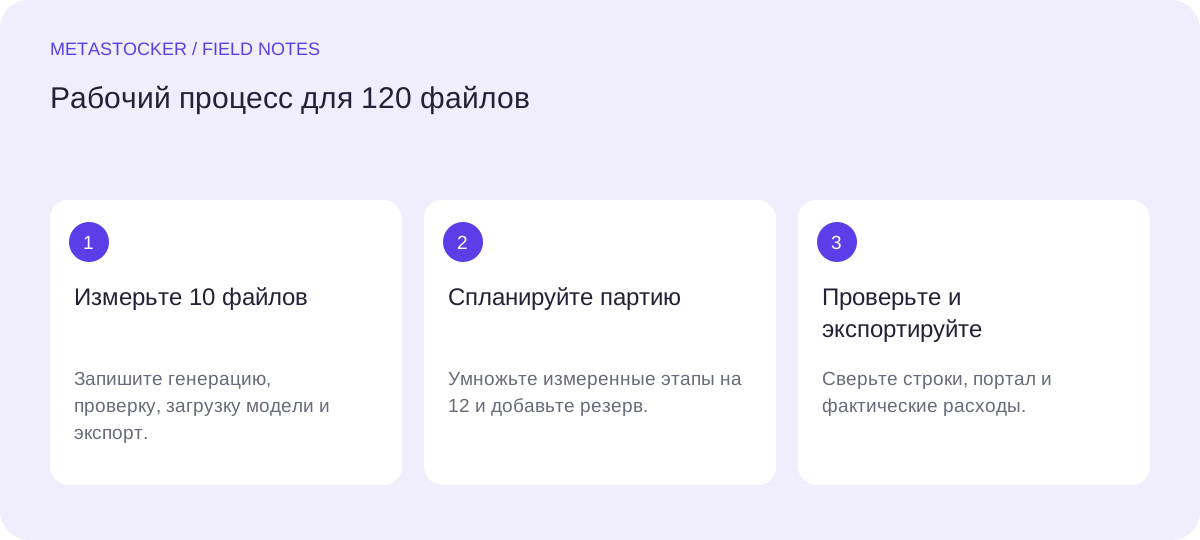
Возьмите 10 representative-файлов: включите самый сложный тип из партии и хотя бы один насыщенный деталями сюжет. Засеките генерацию от запуска до готовности результатов к проверке. Время загрузки модели запишите отдельно: загрузка в память не равна скачиванию файлов и не равна хранению браузерного кэша.
Удобно разделить таблицу на четыре этапа: подготовка модели, генерация, редакторская проверка и подготовка экспорта. Не прячьте сбой браузера или повторный запуск в среднем времени — отметьте его как ограничение.
Локальный режим работает через WebGPU в браузере, поэтому важны совместимые браузер, GPU, драйвер и доступная память. Начните с одного параллельного потока. Два потока могут загрузить отдельные копии модели и создать дополнительную нагрузку.
- Проверьте 10 файлов, близких к реальной партии.
- Запишите начало и конец каждого этапа.
- Отделите разовую подготовку от обработки файлов.
- Второй поток тестируйте только после стабильного первого.
Колонки рабочего листа:
Этап | Начало | Конец | Минуты | Примечание
Подготовка модели | __ | __ | __ | скачана, загружена или уже доступна
Генерация 10 файлов | __ | __ | __ | один или два потока
Проверка 10 файлов | __ | __ | __ | исправления и исключения
Подготовка экспорта | __ | __ | __ | только готовые строки
Рабочий пример: расчёт для 120 файлов
Условный пример: автор измерил 10 похожих изображений и получил 18 минут генерации, 22 минуты проверки и 3 минуты подготовки экспорта. Модель уже была в памяти; разовая подготовка заняла бы отдельно 7 минут. Это придуманные числа для демонстрации метода, а не заявленная скорость MetaStocker.
Для 120 файлов нужно 12 групп по 10. Тогда генерация составит 216 минут, а проверка — 264 минуты. Если экспортировать каждую группу отдельно, можно заложить 36 минут на 12 подготовок. Если проверять всю партию и экспортировать один раз, не подставляйте оптимистичное значение без отдельного измерения.
В этой условной таблице итог равен 7 + 216 + 264 + 3 = 490 минутам, то есть 8 часам 10 минутам. Это не обещание срока, а расчёт из наблюдений автора примера. После первых 30 файлов обновите оценку и добавьте понятный резерв на повторные запуски, сложные изображения и перерывы.
- Генерация образца: 18 минут на 10 файлов
- Проверка образца: 22 минуты на 10 файлов
- Условная подготовка модели: 7 минут один раз
- Условный итог: 490 минут до дополнительного резерва
Формула:
Группы = 120 / 10 = 12
Генерация = 18 × 12 = 216 минут
Проверка = 22 × 12 = 264 минуты
Итог = 7 + 216 + 264 + 3 = 490 минут
Замените каждое условное число собственным измерением.
Учтите локальные ограничения вместо выдуманной цены
Локальный режим не требует аккаунта или API-ключа, но первая загрузка модели требует интернета. Запишите её как разовую подготовку. Скачанные файлы могут остаться в браузерном кэше, однако кэш — не активная память модели. При выгрузке модель можно убрать из памяти, сохранив кэш; браузер вправе очистить хранилище, поэтому нельзя обещать постоянную работу офлайн.
В рабочем листе фиксируйте размер загрузки, свободное место, поведение памяти, выбранную модель и отзывчивость компьютера. Если партия остановилась, запишите номер группы и время повторного запуска.
Проверяйте смысл каждого результата. Проверка требуемого количества тегов не доказывает их точность. Дополнительные теги особенно внимательно сверяйте в смешанной партии. Для видео просмотр отдельных превью не заменяет проверки всего движения.
- Локальный бюджет — время компьютера, место и внимание на проверку.
- Не смешивайте активную память модели с браузерным кэшем.
- Удаляйте файлы модели только после решения, что сохранять.
- Сохраняйте редактируемые метаданные вне вкладки браузера.
Отдельно проверьте возможный API-счёт
Если локальная обработка не подходит, дополнительный платный режим может использовать собственный ключ OpenAI и отправлять провайдеру превью или контекст. Ключ является секретом: не помещайте его в общий документ, публичный клиентский код или опубликованный пример.
Не вычисляйте счёт по придуманной цене за файл. Перед запуском запишите аккаунт, выбранную модель, период и идентификатор партии. После небольшого пилота откройте панель использования и биллинга провайдера. Сравните фактический расход пилота с числом файлов и отправленным контекстом, затем решите, продолжать ли обработку.
Ведите локальную и API-обработку в разных строках. У локального запуска нет API-счёта, а у API-запуска могут быть расходы провайдера. Локальная ошибка не означает автоматического перехода в облако: такого резервного переключения приложение не выполняет.
- Проверьте актуальные цены и расход в аккаунте провайдера.
- Сначала обработайте небольшую пилотную группу.
- Записывайте фактическое использование, а не цену по догадке.
- При раскрытии ключа немедленно удалите или замените его.
Контроль API:
Файлы пилота: __
Модель: __
Расход в панели провайдера: __
Показанная сумма: __
Решение для остатка: локально / API / пересмотреть партию
Завершите проверку и экспорт
После генерации отредактируйте результаты и экспортируйте только готовые строки. Для Adobe CSV имя файла, расширение и регистр должны совпадать с загруженными файлами; сами файлы загружаются до импорта CSV. После импорта вручную осмотрите метаданные в кабинете автора — это не автоматическая проверка принятия CSV.
Составьте список исключений: сомнительные сюжеты, отсутствующие релизы, неясные места, видимый текст и теги, которые нужно удалить. Язык метаданных Adobe должен соответствовать языку аккаунта. Правила площадок меняются, поэтому перед финальной отправкой снова откройте текущий портал.
В конце сравните план и факт по каждому этапу. В следующей партии вы поймёте, что было настоящим ограничением: генерация, ручная проверка или исправления.
- Экспортируйте только проверенные строки.
- Сверьте имя и расширение каждого файла.
- Осмотрите импортированные метаданные в текущем кабинете.
- Сохраните рабочий лист вместе с записью о партии.
- Пересчитайте следующую оценку по фактическому времени.
Перед следующим шагом
- Измерьте локальную обработку 10 representative-файлов.
- Отделите подготовку модели от генерации.
- Начните с одного потока и отдельно протестируйте два.
- Умножьте измеренные этапы на 12 для 120 файлов.
- Проверьте релевантность и сомнительные утверждения по каждому файлу.
- Перед загрузкой проверьте актуальные правила площадки.
- При API-режиме сверяйте фактический расход и счёт провайдера.
- Храните ключи в секрете и экспортируйте только готовые строки.
Источники и редакционный подход
Материал подготовлен с помощью AI. Примеры в тексте учебные. Автоматические проверки не заменяют проверки требований вашего стока. Как мы готовим материалы.