 MetaStocker
Локальный AI
Как проверить Gemma и Qwen для стоковых метаданных
Чтобы понять, подходит ли вам Gemma или Qwen для стоковых метаданных, проведите небольшой повторяемый тест. Важен не абстрактный вопрос о «лучшой» модели, а конкретный: какая модель оставляет меньше фактических ошибок и требует меньше ручной правки в вашем типе съёмки. MetaStocker предоставляет локальные модели Gemma и Qwen, работающие в браузере через WebGPU. В локальном режиме вывод модели не отправляется на сервер искусственного интеллекта. Ниже описана схема для пяти изображений с одинаковым промптом и числом тегов, таблицей ошибок и замером времени редактирования. Такой результат относится к вашему набору и процессу, а не является универсальным рейтингом.
Зафиксируйте условия до запуска
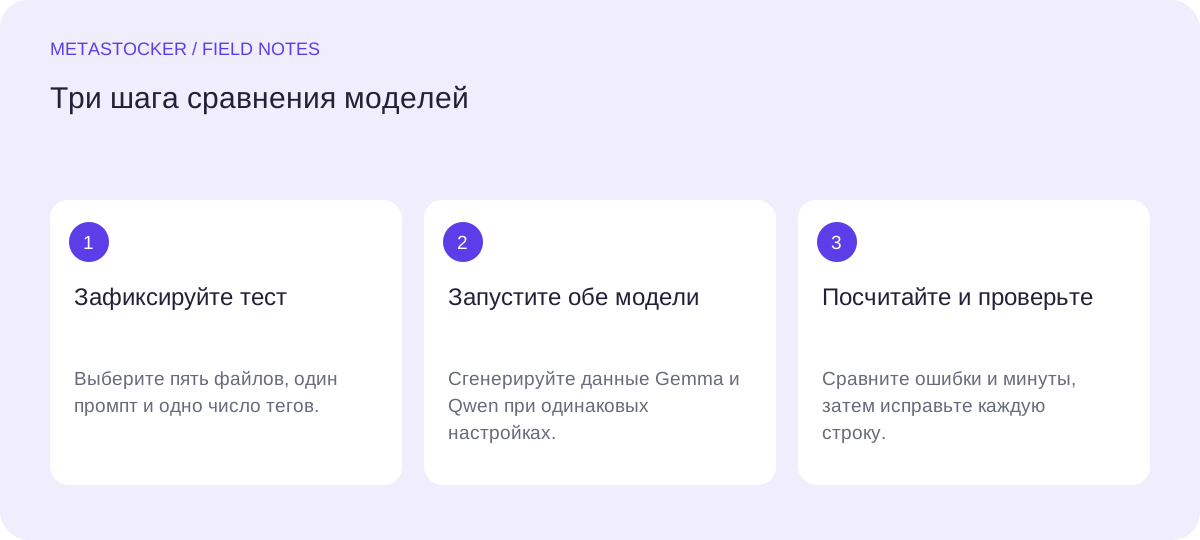
Выберите пять файлов, похожих на вашу обычную стоковую работу. Например, возьмите предметную сцену, пейзаж, еду, интерьер без людей и транспорт. Не делайте выбор слишком лёгким: полезно добавить кадры с неясным видом растения, нечитаемой этикеткой или неизвестным местом.
Составьте один короткий промпт на языке метаданных. Укажите проверенные факты, нужное назначение и точное число тегов. Используйте тот же текст, порядок файлов и лимит для обеих моделей. Не подсказывайте второй модели после просмотра первого результата, иначе сравнение перестанет быть одинаковым.
- Запишите имя файла и краткую проверенную справку о каждом изображении.
- Заранее установите число тегов, например 20 на файл.
- Определите, что считать фактической ошибкой, нерелевантным тегом и пропуском.
Запись теста: пять файлов; метаданные на английском; по 20 ключевых слов; один промпт; ручная проверка каждого результата.
Сформулируйте промпт без догадок
Промпт должен дать контекст, но не подменять анализ изображения. Напишите видимые или подтверждённые факты и ограничения. Если вы знаете, что на снимке керамическая кружка, но не знаете производителя, так и укажите. Попросите не придумывать бренды, имена, места, даты, виды животных или растений и сведения о релизах.
Для Gemma и Qwen нужен буквально один и тот же текст. Описание партии в приложении должно быть фактическим контекстом, а не рекламным абзацем. Даже хороший промпт не устраняет ошибки, поэтому каждый результат нужно просматривать и редактировать.
- Укажите подтверждённый объект, окружение и назначение изображения.
- Запретите догадки о личности, владельце, местоположении, виде и бренде.
- Не просите утверждений, которых нет на снимке или в ваших записях.
Промпт: Создай точный английский заголовок и 20 релевантных ключевых слов для каждого файла. Используй только видимые или предоставленные факты. Не додумывай имена, бренды, точные места, даты, виды или демографические признаки. Сначала поставь важнейшие понятия.
Запустите Gemma и Qwen локально
В MetaStocker выберите локальную модель, при необходимости скачайте её и загрузите перед генерацией. В подтверждённом наборе есть Gemma 4 E2B, Gemma 4 E4B и Qwen3.5 2B; Gemma E2B установлена по умолчанию. Начните с одного параллельного потока. Второй поток может загрузить отдельную копию модели и потребовать больше памяти, поэтому добавляйте его только после устойчивого первого запуска.
Поддержка WebGPU сама по себе не означает, что памяти хватит. Нужны совместимые браузер, защищённый контекст, видеокарта и драйвер, но даже поддерживающий API браузер может не вместить модель. Запишите модель, устройство, браузер и число потоков. Загруженная в память модель — не то же самое, что файлы в кэше браузера: выгрузка может оставить кэш, а удаление файлов очистит локальное хранилище.
- Сначала прогоните все пять файлов через Gemma с фиксированными настройками.
- Повторите тот же прогон через Qwen.
- Отдельно отмечайте проблемы загрузки и памяти, не смешивая их с качеством текста.
Рабочий пример: таблица для пяти файлов
Пример: вы снимаете многоразовую бутылку на студийном столе, красный велосипед у однотонной стены, миску с дольками апельсина, туманную лесную тропу и ноутбук с пустым экраном дизайна. В ваших записях подтверждены предметы, но нет бренда бутылки, владельца велосипеда, места леса или названия программы. Один и тот же промпт просит 20 английских ключевых слов: сначала запускается Gemma, затем Qwen.
Сохраните исходный вывод до исправлений. Для каждого файла посчитайте фактические ошибки, нерелевантные или повторяющиеся слова, пропущенные важные понятия и минуты до готовой строки. Менее удачный синоним не всегда является фактической ошибкой. Придуманный бренд или точное место — ошибка, даже если формулировка звучит правдоподобно. Пропуски и неверные утверждения записывайте раздельно.
- Сделайте одну строку на файл и отдельные блоки столбцов для моделей.
- Храните исходный вывод отдельно от исправленных метаданных.
- Не называйте таблицу научным бенчмарком или доказательством превосходства модели.
Файл | Модель | Фактические ошибки | Нерелевантные/повторные теги | Пропуски | Минуты правки
bottle.jpg | Gemma E2B | 1 выдуманный бренд | 2 | 1 | 4
bottle.jpg | Qwen3.5 2B | 0 | 1 | 2 | 3
Примите решение по нагрузке на редактора
Сравните суммы, но обязательно посмотрите отдельные строки. Модель с меньшим числом ошибок может требовать больше времени из-за неуклюжих заголовков или неполных полезных терминов. Быстрый результат на простых предметах также не гарантирует удобства на неоднозначных кадрах. Практичное решение может быть условным: одну модель использовать для понятных серий, а другую — там, где её предложения легче исправлять.
Не превращайте пять изображений в заявление, что одна модель всегда лучше. Запишите выборку, дату, промпт, число тегов и настройки, чтобы повторить тест после обновления модели. Проверка приложением точного количества тегов подтверждает только количество, а не правдивость и не принятие площадкой.
- Выберите модель с меньшей и безопаснее контролируемой ручной нагрузкой.
- Сохраните примеры серьёзных ошибок как предупреждения для будущих промптов.
- Перед окончательным выбором повторите проверку на новой серии.
Проверьте строки перед экспортом
Проверьте заголовок и каждый тег отдельно. Удалите повторы и догадки, а важнейшие понятия поставьте раньше, если этого требует целевая площадка. Например, общая инструкция Adobe допускает до 49 ключевых слов, но язык метаданных должен соответствовать языку аккаунта. Перед экспортом сверяйтесь с текущими правилами кабинета: требования площадок могут измениться.
MetaStocker умеет экспортировать CSV для поддерживаемых площадок, но экспорт не означает загрузку или отправку. Проверьте имена файлов, строки и специальные поля уже в кабинете. Не рассчитывайте на встраивание метаданных в оригиналы, гарантию принятия или сохранение незавершённой работы после закрытия вкладки. Для видео самостоятельно просматривайте весь ролик: выборочные превью могут пропустить важный контекст.
- Экспортируйте только проверенные и исправленные строки.
- Сверьте актуальные правила площадки и точное совпадение имён файлов.
- Храните оригиналы и таблицу сравнения отдельно от экспортированного CSV.
Перед следующим шагом
- Выберите пять типичных и неоднозначных изображений.
- Напишите один фактический промпт и зафиксируйте число тегов.
- Запустите Gemma и Qwen с одинаковыми файлами и настройками.
- Запишите модель, устройство, браузер, потоки и проблемы памяти.
- Посчитайте ошибки, нерелевантные или повторные теги, пропуски и минуты правки.
- Проверьте каждую строку и актуальные правила площадки перед экспортом.
- Описывайте результат как тест рабочего процесса, а не общий рейтинг.
Источники и редакционный подход
Материал подготовлен с помощью AI. Примеры в тексте учебные. Автоматические проверки не заменяют проверки требований вашего стока. Как мы готовим материалы.