 MetaStocker
Локальный AI
Сколько потоков локального ИИ запускать
Несколько одновременных запросов локального ИИ иногда помогают обработать пакет удобнее, но параллельность не бывает бесплатной. Каждому локальному рабочему потоку может понадобиться собственная копия загруженной модели, поэтому добавление потоков увеличивает потребление памяти и конкуренцию за один GPU. Важен не вопрос «какое число максимально», а вопрос «какое число стабильно работает на этом устройстве».
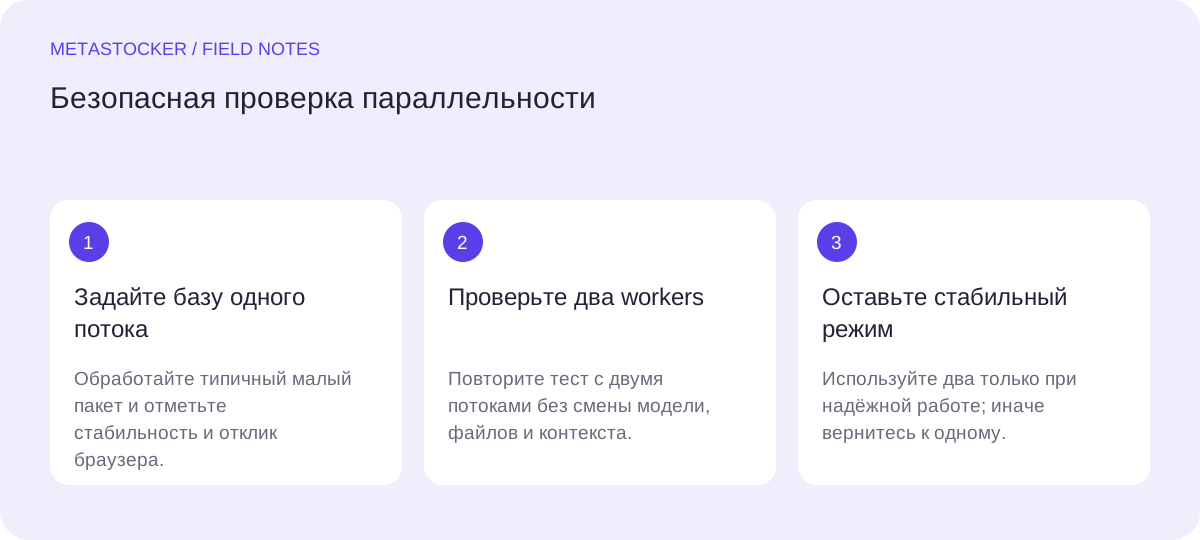
Здесь примером служит локальная обработка в браузере MetaStocker. Метод применим и к другим браузерным локальным моделям: сначала измерьте работу с одним потоком, затем проверьте два потока на небольшом пакете и оставьте повышенное значение лишь при стабильном улучшении без ошибок и заметного замедления остальных действий.
Что на самом деле потребляет поток
Локальный поток — это рабочий процесс, который обслуживает запрос ИИ. В MetaStocker локальное выполнение использует workers WebGPU в браузере. Второй worker может обрабатывать другой запрос, но ему может потребоваться отдельная копия выбранной модели. Поэтому расход памяти способен расти примерно вместе с числом активных копий модели, а не как небольшой накладной расход настройки.
Требования зависят от модели, браузера, GPU, драйвера, размера изображений, контекста запроса и других открытых приложений. Поддержка WebGPU сама по себе не доказывает, что памяти хватит для конкретной модели. Считайте число потоков параметром нагрузки, а не величиной, которую можно вычислить только по объёму RAM.
- Дополнительные потоки могут помочь, если у устройства есть запас ресурсов.
- Они же могут вызвать нехватку памяти, конкуренцию, ошибки или новые задержки.
- Кэш браузера хранит файлы модели, но это не то же самое, что память активной модели.
Сначала установите базовый режим
Начните с одного локального потока и небольшого, но типичного пакета. Используйте ту же модель, контекст, тип файлов и браузер, которые планируете применять в работе. Отметьте, загружается ли модель, завершаются ли запросы, остаётся ли браузер отзывчивым и не приходится ли чрезмерно исправлять результат.
В MetaStocker модель сначала скачивается для локальной работы, а затем явно загружается для выполнения запросов. Выгрузка может освободить активную память, сохранив файлы в кэше; удаление файлов модели из браузера — отдельное действие. Завершённая загрузка не означает, что несколько активных workers поместятся одновременно.
- Перед проверкой закройте лишние вкладки с нагрузкой на GPU.
- Тестируйте обычные рабочие превью, а не только маленькие файлы.
- Сохраните результат одного потока как точку сравнения.
Проверьте два потока контролируемо
После стабильной проверки одного потока запустите два на небольшом пакете. Ничего больше не меняйте. Сравнивайте весь процесс: запуск модели, поведение очереди, отзывчивость браузера, надёжность завершения и объём последующей проверки метаданных.
Два потока — разумный следующий эксперимент: он показывает, есть ли у устройства практический запас, но не заставляет сразу выбирать большое число workers. Если два потока завершаются стабильно и браузер остаётся удобным, проведите более длинную пробу. Если весь запуск стал медленнее, нестабилен или труднее для контроля, вернитесь к одному.
- Меняйте только число потоков.
- Прекратите проверку, если браузер становится нестабильным или ошибки повторяются.
- Надёжное завершение важнее заполненной очереди.
Гипотетический пример: автор готовит 12 изображений с приготовлением еды и выбирает Gemma E2B. Сначала он обрабатывает четыре изображения одним потоком и отмечает стабильную работу браузера. Затем повторяет проверку на четырёх похожих файлах с двумя потоками. Если второй режим завершается приемлемо, а браузер остаётся отзывчивым, он запускает остальные файлы в том же режиме. Если workers конкурируют за память, а запуск замедляется или завершается ошибками, он оставляет один поток. Это решение для рабочего процесса, а не измеренный результат.
Почему параллельный запуск бывает медленнее
Параллельная работа может оказаться медленнее даже при двух активных запросах. Workers конкурируют за память GPU, браузер тратит время на перемещение данных, а устройство может начать восстанавливаться после давления на память. На маленьком пакете основное время также может уходить на загрузку модели, поэтому дополнительные потоки не дают заметного эффекта.
Проверьте, повторяется ли замедление на более крупной, сопоставимой выборке. Обратите внимание на задержки интерфейса, незавершённые генерации, повторные ошибки, перезагрузку модели и нестабильную вкладку. Сравнивайте общий объём пригодного результата и усилия на проверку, а не только число одновременно запущенных запросов.
- Если доминирует запуск, используйте пакет, где видна основная рабочая нагрузка.
- Если сбой возникает на крупных превью, попробуйте уменьшить их размер, когда это допустимо.
- При медленном интерфейсе закройте другие задачи, нагружающие GPU, и повторите тест.
Как разбирать ошибки и нехватку памяти
Ошибки после увеличения параллельности означают, что текущая настройка слишком агрессивна для этого окружения, даже если один поток работает. Вернитесь к одному, чтобы убедиться, что модель и файлы по-прежнему исправны. Затем проверьте два потока на меньшем пакете, с более коротким контекстом или в новой сессии браузера. Если один стабилен, а два нет, практический выбор — один.
Не рассчитывайте, что добавление обычной оперативной памяти решит любую проблему. Причиной могут быть браузер, GPU, драйвер, модель и ограничения превью. И не смешивайте кэшированную модель с активно загруженной: они используют ресурсы по-разному. Если сбой остаётся даже при одном потоке, отдельно проверьте загрузку модели, совместимость браузера, WebGPU, превью файлов и доступные ресурсы устройства.
- Повторите проблему на одном потоке.
- Отделите ошибку загрузки модели от ошибки пакетной обработки.
- Записывайте браузер, модель, тип файла и число потоков для каждого теста.
Сформулируйте рабочее правило
Для большинства задач достаточно простого правила: по умолчанию использовать один поток, на конкретном устройстве проверить два и оставить два только при стабильной работе и реальном удобстве. Универсальной формулы RAM или магического числа потоков нет: меняются активные копии модели и нагрузка браузера.
Повторяйте проверку после смены модели, браузера, драйвера, размера превью или контекста. Локальное выполнение MetaStocker остаётся на устройстве посетителя и не переключается автоматически на облачную модель, если локальная параллельность не справилась. Перед экспортом проверяйте редактируемые метаданные, особенно для видео: выборочные превью не показывают каждое мгновение полного ролика.
- По умолчанию: один поток.
- Эксперимент: два потока на небольшом контролируемом пакете.
- Решение: оставить самый стабильный режим, а не самое большое доступное число.
Перед следующим шагом
- Проверьте типичный пакет одним потоком.
- Проверьте два потока, не меняя остальные условия.
- Следите за признаками давления на память, отзывчивостью браузера и ошибками.
- Сравните общий пригодный результат и усилия на проверку.
- Вернитесь к одному потоку, если параллельность замедляет или ломает работу.
- Повторите тест после смены модели, браузера, превью или контекста.
- Проверьте метаданные перед экспортом готовых строк.
Источники и редакционный подход
Материал подготовлен с помощью AI. Примеры в тексте учебные. Автоматические проверки не заменяют проверки требований вашего стока. Как мы готовим материалы.